Prywatność w AI: co dzieje się z tym, co wpisujesz do narzędzi?
Korzystanie z narzędzi AI potrafi być zaskakująco swobodne. Wpisujesz fragment umowy, prosisz o analizę wyników badań, wklejasz wiadomość od klienta albo przesyłasz dokument do skrócenia. Po chwili otrzymujesz odpowiedź i wracasz do swoich zadań. Właśnie w tej prostocie kryje się najważniejsze pytanie: co dzieje się z informacją po naciśnięciu przycisku wysyłania?
Odpowiedź zależy od konkretnej usługi, rodzaju konta i ustawień prywatności. Jedna zasada pozostaje jednak uniwersalna: treść przekazana dla narzędzia AI przestaje być wyłącznie informacją zapisaną na Twoim urządzeniu. Dlatego warto rozumieć drogę danych, zanim powierzysz systemowi coś, czego nie wysłałbyś przypadkowej osobie.
Co dzieje się z treścią po wysłaniu jej do narzędzia AI?
Najpierw oddzielmy korzystanie z modelu od potocznego wyobrażenia, że program „czyta” tekst i natychmiast o nim zapomina. Usługi działające przez internet zazwyczaj przesyłają wpisaną treść do infrastruktury dostawcy, gdzie model analizuje dane i tworzy odpowiedź. W zależności od zasad konkretnej platformy część informacji może trafić również do historii rozmów, dzienników technicznych albo procesów służących ulepszaniu usługi.
Typowa droga informacji może obejmować następujące etapy:
- przesłanie treści z Twojego urządzenia do systemu dostawcy usługi;
- analizę polecenia przez model oraz utworzenie odpowiedzi na podstawie przekazanego kontekstu;
- zapis rozmowy na koncie, jeśli usługa przechowuje historię konwersacji;
- przechowywanie wybranych danych technicznych potrzebnych do bezpieczeństwa, diagnostyki albo rozliczeń;
- wykorzystanie treści do ulepszania modeli, jeśli regulamin, rodzaj konta i Twoje ustawienia przewidują taki sposób przetwarzania.
Najważniejszy wniosek brzmi prosto: zamknięcie okna rozmowy nie musi być równoznaczne z usunięciem przesłanej treści. Okres przechowywania oraz dalsze wykorzystanie informacji wynikają z polityki narzędzia.
Plik, zdjęcie i nagranie również stają się częścią zapytania
Prywatność nie dotyczy wyłącznie tekstu. Załączony arkusz może zawierać nazwiska i wynagrodzenia, fotografia ekranu może ujawnić adres poczty, a dokument z tabelą może zawierać komentarze, historię zmian albo dane zapisane w metadanych pliku (informacjach opisujących plik, na przykład autora lub datę utworzenia).
Przed wysłaniem załącznika warto więc patrzeć na materiał szerzej niż na jego widoczną treść. Jeśli potrzebujesz pomocy przy jednym akapicie umowy, przesłanie całego dokumentu zwiększa ilość informacji powierzonych usługodawcy. Im szerszy materiał źródłowy, tym większa odpowiedzialność za sprawdzenie, czy nie zawiera danych zbędnych dla konkretnego zadania.
Odpowiedź na ekranie to tylko fragment procesu
Z perspektywy użytkownika rozmowa kończy się po otrzymaniu odpowiedzi. Z perspektywy systemu pozostają jeszcze kwestie bezpieczeństwa, historii konta, wykrywania nadużyć, zgłoszeń użytkowników i jakości działania usługi. Z tego powodu przed przesłaniem poufnych materiałów warto sprawdzić, czy rozmowy są zachowywane, jak długo pozostają na serwerach oraz czy można wyłączyć używanie ich do ulepszania modeli.
OpenAI informuje, że treści z usług dla użytkowników indywidualnych mogą służyć poprawie modeli, natomiast użytkownik może wyłączyć takie wykorzystanie w ustawieniach kontroli danych. Google podaje z kolei, że rozmowy w aplikacjach Gemini wybrane do oceny przez człowieka mogą być przechowywane do trzech lat, nawet po usunięciu aktywności z konta.
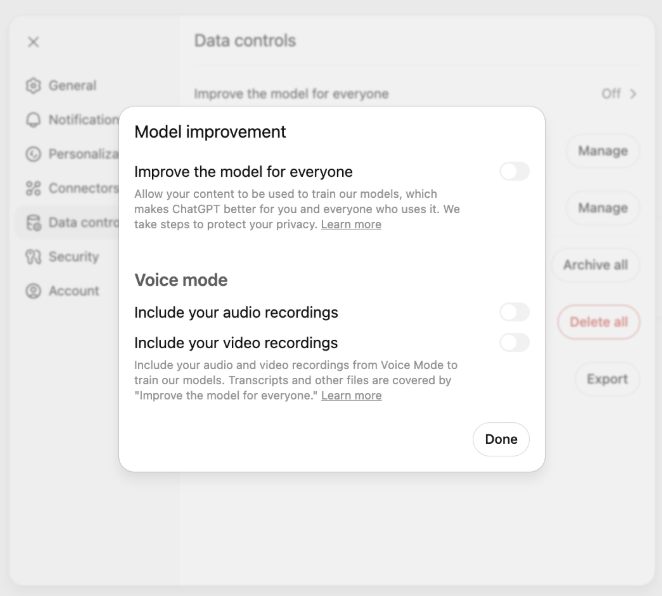
Przykład przetwarzania danych – ChatGPT. Źródło: help.openai.com/en/articles/8983130-what-if-i-want-to-keep-my-history-on-but-disable-model-training
Prywatność w AI – czy narzędzie AI zapamiętuje wszystko, co wpisujesz?
Słowo „zapamiętuje” bywa mylące, ponieważ łączy trzy odrębne mechanizmy: historię rozmów, pamięć funkcji personalizujących oraz wykorzystanie danych do uczenia modeli. Te procesy nie są tym samym i mogą podlegać zupełnie innym ustawieniom.
Historia rozmów służy przede wszystkim Tobie
Historia pozwala wrócić do wcześniejszej konwersacji, kontynuować temat albo odszukać przesłany materiał. Jej obecność nie przesądza automatycznie, że cała treść trafi do zbioru wykorzystywanego podczas uczenia modelu. Trzeba sprawdzić osobno zasady przechowywania rozmów oraz zasady ulepszania systemu.
Istotny jest też czas
Usunięcie rozmowy z widoku konta nie zawsze prowadzi do natychmiastowego skasowania wszystkich kopii technicznych. Dostawca może zachować określone dane przez ustalony okres z powodów bezpieczeństwa, przeciwdziałania nadużyciom lub obowiązków prawnych. Informacja o takim okresie powinna znajdować się w dokumentacji prywatności konkretnej usługi.
Uczenie modelu nie polega na dopisywaniu Twojego zdania do odpowiedzi dla innych
Model językowy uczy się wzorców występujących w danych. Nie działa jak publiczny notatnik, do którego po każdej rozmowie dopisywany jest nowy akapit dostępny dla kolejnego użytkownika. Ryzyko prywatności nadal istnieje, ponieważ treści mogą być przechowywane, analizowane, oceniane lub wykorzystywane w procesach rozwoju systemu zgodnie z zasadami dostawcy.
Dlatego pytanie „czy AI się na tym uczy?” warto zastąpić bardziej precyzyjnym zestawem pytań:
- czy rozmowa jest zapisywana,
- kto może mieć do niej dostęp,
- przez jaki okres jest przechowywana,
- czy można wyłączyć jej wykorzystanie do ulepszania usługi.
Taka perspektywa daje znacznie więcej informacji niż jedno ogólne hasło o „trenowaniu AI”.
Rodzaj konta potrafi zmienić zasady przetwarzania
Ta sama marka może stosować inne reguły dla kont indywidualnych, firmowych i usług przeznaczonych do integracji z systemami przedsiębiorstwa. OpenAI podaje, że dane przesyłane przez jego interfejs programistyczny nie są wykorzystywane do uczenia modeli, chyba że organizacja świadomie wyrazi na to zgodę. Google informuje natomiast, że w Gemini używanym przez uprawnione konta służbowe lub szkolne rozmowy i przesłane pliki nie są oceniane przez człowieka ani wykorzystywane do ulepszania generatywnych modeli AI.
Dlatego nazwa narzędzia sama w sobie nie wystarcza do oceny prywatności. Liczy się jeszcze plan, typ konta, administrator organizacji i ustawienia. Przed pracą z dokumentem firmowym sprawdź zasady przypisane do środowiska, z którego korzystasz.
Jakie dane są szczególnie ryzykowne podczas rozmowy z AI?
Największe zagrożenie pojawia się w chwili, w której wygoda wygrywa z selekcją informacji. Kopiujesz całą wiadomość zamiast potrzebnego akapitu. Wklejasz umowę wraz z nazwiskami, numerami dokumentów i stawkami. Prosisz o poprawę kodu razem z hasłem zapisanym w konfiguracji. Model może potrzebować kontekstu, ale nie potrzebuje każdej informacji znajdującej się w źródłowym materiale.
Szczególnej ostrożności wymagają:
- dane logowania, hasła, kody jednorazowe, klucze dostępowe i informacje służące do odzyskiwania konta;
- dane osobowe pozwalające rozpoznać konkretną osobę, w tym numery dokumentów, adresy, telefony oraz prywatne adresy poczty;
- informacje zdrowotne, finansowe, prawne i rodzinne, mogące ujawniać szczególnie osobiste okoliczności;
- tajemnice przedsiębiorstwa, niepublikowane wyniki, plany cenowe, treść negocjacji, kod źródłowy oraz dokumentacja wewnętrzna;
- dane klientów, pracowników, kontrahentów i innych osób, ponieważ ich prywatność nie przestaje mieć znaczenia tylko dlatego, że to Ty przesyłasz materiał.
Skala problemu nie jest wyłącznie teoretyczna. W badaniu Cisco z 2024 roku 30% użytkowników generatywnej AI deklarowało wpisywanie do takich narzędzi danych osobowych lub poufnych, w tym informacji finansowych i zdrowotnych. Jednocześnie 84% badanych obawiało się, że przekazane dane mogą stać się publiczne.
Największa luka często powstaje więc przed wysłaniem wiadomości, a nie po stronie samego modelu. Jeśli przekazujesz systemowi pełny dokument, choć do odpowiedzi wystarczyłby anonimowy fragment, zwiększasz zakres danych narażonych na niepotrzebne przetwarzanie.
Prywatność w AI zaczyna się przed wpisaniem pytania
Europejskie przepisy o ochronie danych opierają się między innymi na zasadzie minimalizacji: przetwarzane dane osobowe powinny być adekwatne, istotne i ograniczone do zakresu potrzebnego dla określonego celu. Komisja Europejska wskazuje również, że tam, gdzie jest to możliwe, warto korzystać z danych anonimowych, zamiast informacji pozwalających rozpoznać osobę.
Ta zasada świetnie porządkuje codzienne korzystanie z AI. Zanim wkleisz dokument, zadaj sobie pytanie, jaka część materiału jest naprawdę potrzebna do wykonania zadania. Nazwisko można zastąpić określeniem „klient A”, numer umowy usunąć, kwoty zaokrąglić, a cały plik zamienić na jeden fragment zawierający problem wymagający analizy.
Anonimizacja i pseudonimizacja zmniejszają zakres ujawnianych informacji
Anonimizacja polega na takim przekształceniu danych, aby nie dało się powiązać ich z konkretną osobą. Pseudonimizacja zastępuje dane identyfikujące innymi oznaczeniami, lecz powiązanie może nadal istnieć w osobnym źródle. Dla użytkownika różnica jest ważna: dokument z wpisem „pracownik 17” może nadal prowadzić do konkretnej osoby, jeśli w firmie istnieje tabela przypisująca numery do nazwisk.
Najbezpieczniejszym nawykiem jest przekazywanie narzędziu wyłącznie tej części informacji, bez której nie da się uzyskać sensownej odpowiedzi. Im mniej zbędnych danych trafia do systemu, tym mniejszy pozostaje zakres informacji wymagających późniejszej ochrony. Od tej zasady zaczyna się świadome korzystanie z AI – zanim jeszcze przejdziesz do ustawień konta, trybów prywatnych i zasad pracy z poufnymi dokumentami.
Ustawienia prywatności w AI: zacznij od tego, co możesz kontrolować
Skoro zakres przekazywanych danych można ograniczyć jeszcze przed wysłaniem wiadomości, kolejny krok prowadzi do ustawień samego narzędzia. Nie każda usługa daje identyczne możliwości, dlatego warto poświęcić krótką chwilę na sprawdzenie zasad dotyczących historii rozmów, usuwania treści oraz wykorzystywania danych do rozwoju modeli.
Nie chodzi o czytanie całego regulaminu od pierwszej do ostatniej strony. Najpierw znajdź informacje odpowiadające na konkretne pytania: jak długo rozmowy pozostają zapisane, czy możesz wyłączyć ich używanie do ulepszania systemu, jak usuwa się historię oraz czy istnieje osobny tryb rozmowy z ograniczonym przechowywaniem danych. Prywatność staje się łatwiejsza do kontrolowania, jeśli wiesz, gdzie kończy się Twoja decyzja, a zaczynają zasady dostawcy.
Przy pierwszej konfiguracji konta sprawdź pięć obszarów:
- sposób zapisywania historii rozmów oraz możliwość jej wyłączenia;
- zasady wykorzystywania przesłanych treści do ulepszania modeli;
- czas przechowywania rozmów, plików i danych technicznych;
- możliwość ręcznego usunięcia konwersacji oraz całego konta;
- ustawienia pamięci lub personalizacji, jeśli narzędzie korzysta z informacji pochodzących z wcześniejszych rozmów.
Zapamiętaj!
Samo wyłączenie historii nie powinno jednak usypiać czujności. Poszczególne usługi mogą zachowywać wybrane dane przez określony czas ze względów bezpieczeństwa, prawnych albo technicznych. Z tego powodu rozsądniej traktować ustawienia prywatności jako dodatkową warstwę ochrony, a nie zgodę na swobodne przesyłanie poufnych materiałów.
Oddziel zastosowania prywatne od służbowych
Konto używane do planowania wakacji nie powinno automatycznie stawać się miejscem analizy umów, danych klientów i wewnętrznych zestawień firmy. W środowisku zawodowym zasady mogą wynikać z umowy z dostawcą, ustawień administratora, polityki bezpieczeństwa oraz przepisów o ochronie danych.
Jeśli pracodawca udostępnia zatwierdzone narzędzie, korzystanie z prywatnego konta może omijać zabezpieczenia przygotowane dla organizacji. Wygodniejsza droga nie zawsze jest bezpieczniejsza dla informacji, za które odpowiadasz służbowo.
Sztuczna inteligencja w pracy: wygoda może wyprzedzić zasady
Problem staje się poważniejszy, kiedy pracownicy samodzielnie wybierają narzędzia bez wiedzy działu odpowiedzialnego za bezpieczeństwo. Raport IBM „Cost of a Data Breach 2025” wskazuje, że jedna na pięć badanych organizacji doświadczyła naruszenia powiązanego z niezatwierdzonym użyciem sztucznej inteligencji. Organizacje intensywnie korzystające z takich rozwiązań odnotowywały średnio o 670 tys. dolarów wyższe koszty naruszeń niż podmioty z niskim poziomem takiego użycia lub bez niego.
Ten sam raport pokazuje szerszy problem organizacyjny: 63% spośród 600 badanych organizacji nie miało zasad zarządzania sztuczną inteligencją, a wśród podmiotów dotkniętych incydentami związanymi z AI aż 97% nie posiadało odpowiednich mechanizmów kontroli dostępu.
Liczby nie powinny prowadzić do wniosku, że narzędzia generatywne są z definicji niebezpieczne. Pokazują coś bardziej użytecznego: ryzyko rośnie, jeśli technologia pojawia się w firmie szybciej niż reguły określające, jakie dane wolno do niej przekazywać.
Przy pracy zawodowej nie wpisuj bez wyraźnej podstawy:
- pełnych baz klientów, list pracowników i danych kontaktowych niezwiązanych z zadaniem;
- haseł, kluczy dostępowych, danych do systemów firmowych oraz informacji uwierzytelniających;
- niepublikowanych wyników finansowych, planów strategicznych, warunków negocjacji i tajemnic przedsiębiorstwa;
- dokumentów zawierających dane osobowe, jeśli ten sam cel możesz osiągnąć po usunięciu elementów identyfikujących.
Jeżeli potrzebujesz analizy treści, najpierw przygotuj wersję roboczą pozbawioną zbędnych danych. Dzięki temu zachowujesz wartość zadania, a jednocześnie ograniczasz zakres informacji wychodzących poza firmowe środowisko.
Co zrobić po przypadkowym wysłaniu poufnych danych?
Pomyłka może zdarzyć się podczas pośpiechu. Wklejasz całą wiadomość zamiast fragmentu, przesyłasz niewłaściwy plik albo zauważasz nazwisko klienta dopiero po otrzymaniu odpowiedzi. Najgorszym ruchem byłoby uznanie, że skoro wiadomość już została wysłana, nie da się nic zrobić.
Zacznij od ograniczenia dalszego rozpowszechniania informacji:
- usuń rozmowę lub plik z konta, korzystając z dostępnych funkcji usługi;
- sprawdź dokumentację dostawcy dotyczącą czasu usuwania danych z systemów;
- zmień hasło, kod lub klucz dostępowy, jeśli właśnie taki sekret znalazł się w przesłanej treści;
- poinformuj osobę odpowiedzialną za bezpieczeństwo albo ochronę danych w firmie, jeśli incydent dotyczy informacji służbowych;
- zanotuj zakres ujawnionych danych, czas zdarzenia i podjęte działania, ponieważ te informacje mogą być potrzebne podczas oceny ryzyka.
Zapamiętaj!
W przypadku danych osobowych reakcja firmy powinna uwzględniać obowiązki wynikające z RODO. Nie każde przypadkowe przesłanie informacji automatycznie prowadzi do zgłoszenia naruszenia organowi nadzorczemu, ponieważ znaczenie ma charakter zdarzenia oraz ryzyko dla konkretnych osób objętych danymi. Ocena powinna należeć do osoby posiadającej odpowiednie kompetencje, a nie do pracownika próbującego samodzielnie „wyczyścić” problem.
Czy RODO chroni dane wpisywane do narzędzi AI? Prywatność z praktycznego punktu widzenia
RODO pozostaje neutralne technologicznie, dlatego obejmuje przetwarzanie danych osobowych także przy wykorzystaniu systemów sztucznej inteligencji. Komisja Europejska przypomina, że organizacja powinna zbierać i przetwarzać wyłącznie dane potrzebne do określonego celu, zgodnie z zasadą minimalizacji. Tam, gdzie cel można osiągnąć bez danych identyfikujących osobę, preferowane jest korzystanie z danych anonimowych.
Ważne jest również rozróżnienie między anonimowością a przekonaniem, że model „raczej nikogo nie rozpozna”. Europejska Rada Ochrony Danych wskazała w opinii 28/2024, że modelu wytrenowanego na danych osobowych nie można automatycznie uznać za anonimowy. Ocena wymaga analizy okoliczności konkretnego przypadku, w tym możliwości pozyskania danych osobowych z modelu albo uzyskania informacji o osobach wykorzystanych podczas jego tworzenia.
Nie przekazuj AI więcej informacji, niż wymaga zadanie
Prywatność w sztucznej inteligencji nie zależy od jednego przełącznika ukrytego w ustawieniach. Powstaje z serii drobnych decyzji: wyboru narzędzia, zakresu przekazywanego materiału, sposobu anonimizacji, rodzaju konta i reakcji na pomyłkę.
Najbardziej użyteczne pytanie przed wysłaniem treści brzmi więc nie „czy mogę wkleić ten dokument?”, lecz „jakiej najmniejszej części tego dokumentu potrzebuje narzędzie, aby mi pomóc?”. Im wcześniej zaczniesz oddzielać potrzebny kontekst od informacji zbędnych, tym łatwiej korzystać z możliwości AI bez oddawania większej części prywatności, niż wymaga konkretne zadanie.
Sztuczna inteligencja może skrócić czas pracy, uporządkować informacje i pomóc w analizie. Korzyść nie wymaga jednak rezygnacji z ostrożności. Najlepszy nawyk jest prosty: zanim coś wyślesz, spójrz na treść jeszcze raz jak na informację, która opuszcza Twoje urządzenie. Ta jedna sekunda często decyduje, czy korzystasz z technologii świadomie, czy wyłącznie szybko.
W Webmetric pomagamy firmom korzystać z technologii w sposób świadomy, bezpieczny i dopasowany do ich potrzeb. Skontaktuj się z nami, jeśli chcesz uporządkować działania cyfrowe i podejmować lepsze decyzje na podstawie danych.